Accélérer l'analyse de graphes en calculant à même la mémoire
Les algorithmes de graphes consacrent souvent plus de temps au déplacement des données qu’à leur traitement. Nos accélérateurs s’attaquent à ce problème en effectuant directement les calculs sur des matrices de mémoire résistive. Le graphe conserve sa représentation compacte jusqu’aux crossbars, tandis que les mêmes configurations sont réutilisées pour les motifs de connexions récurrents.
Bon nombre des systèmes que nous utilisons chaque jour se comprennent à travers des relations. Un réseau social relie des personnes, un système financier relie des comptes par des transactions, et une carte routière relie des intersections par des routes. En informatique, on représente ces relations par des graphes : des ensembles d’éléments et les connexions qui les relient.
Les graphes sont omniprésents, mais ils posent une difficulté particulière aux ordinateurs. Le problème tient généralement à la localisation des données nécessaires à l’étape suivante, et non au calcul lui-même. À mesure qu’un algorithme de graphe progresse, le processeur doit consulter à répétition les voisins d’un élément après l’autre. Ces connexions sont habituellement dispersées dans la mémoire, ce qui force le processeur à faire circuler de grandes quantités de données. Lorsque les graphes atteignent des milliards de connexions, ces déplacements de données deviennent une source majeure de temps d’exécution et de consommation énergétique.
Nos travaux explorent une autre approche : rapprocher le calcul des données en calculant directement à même la mémoire.
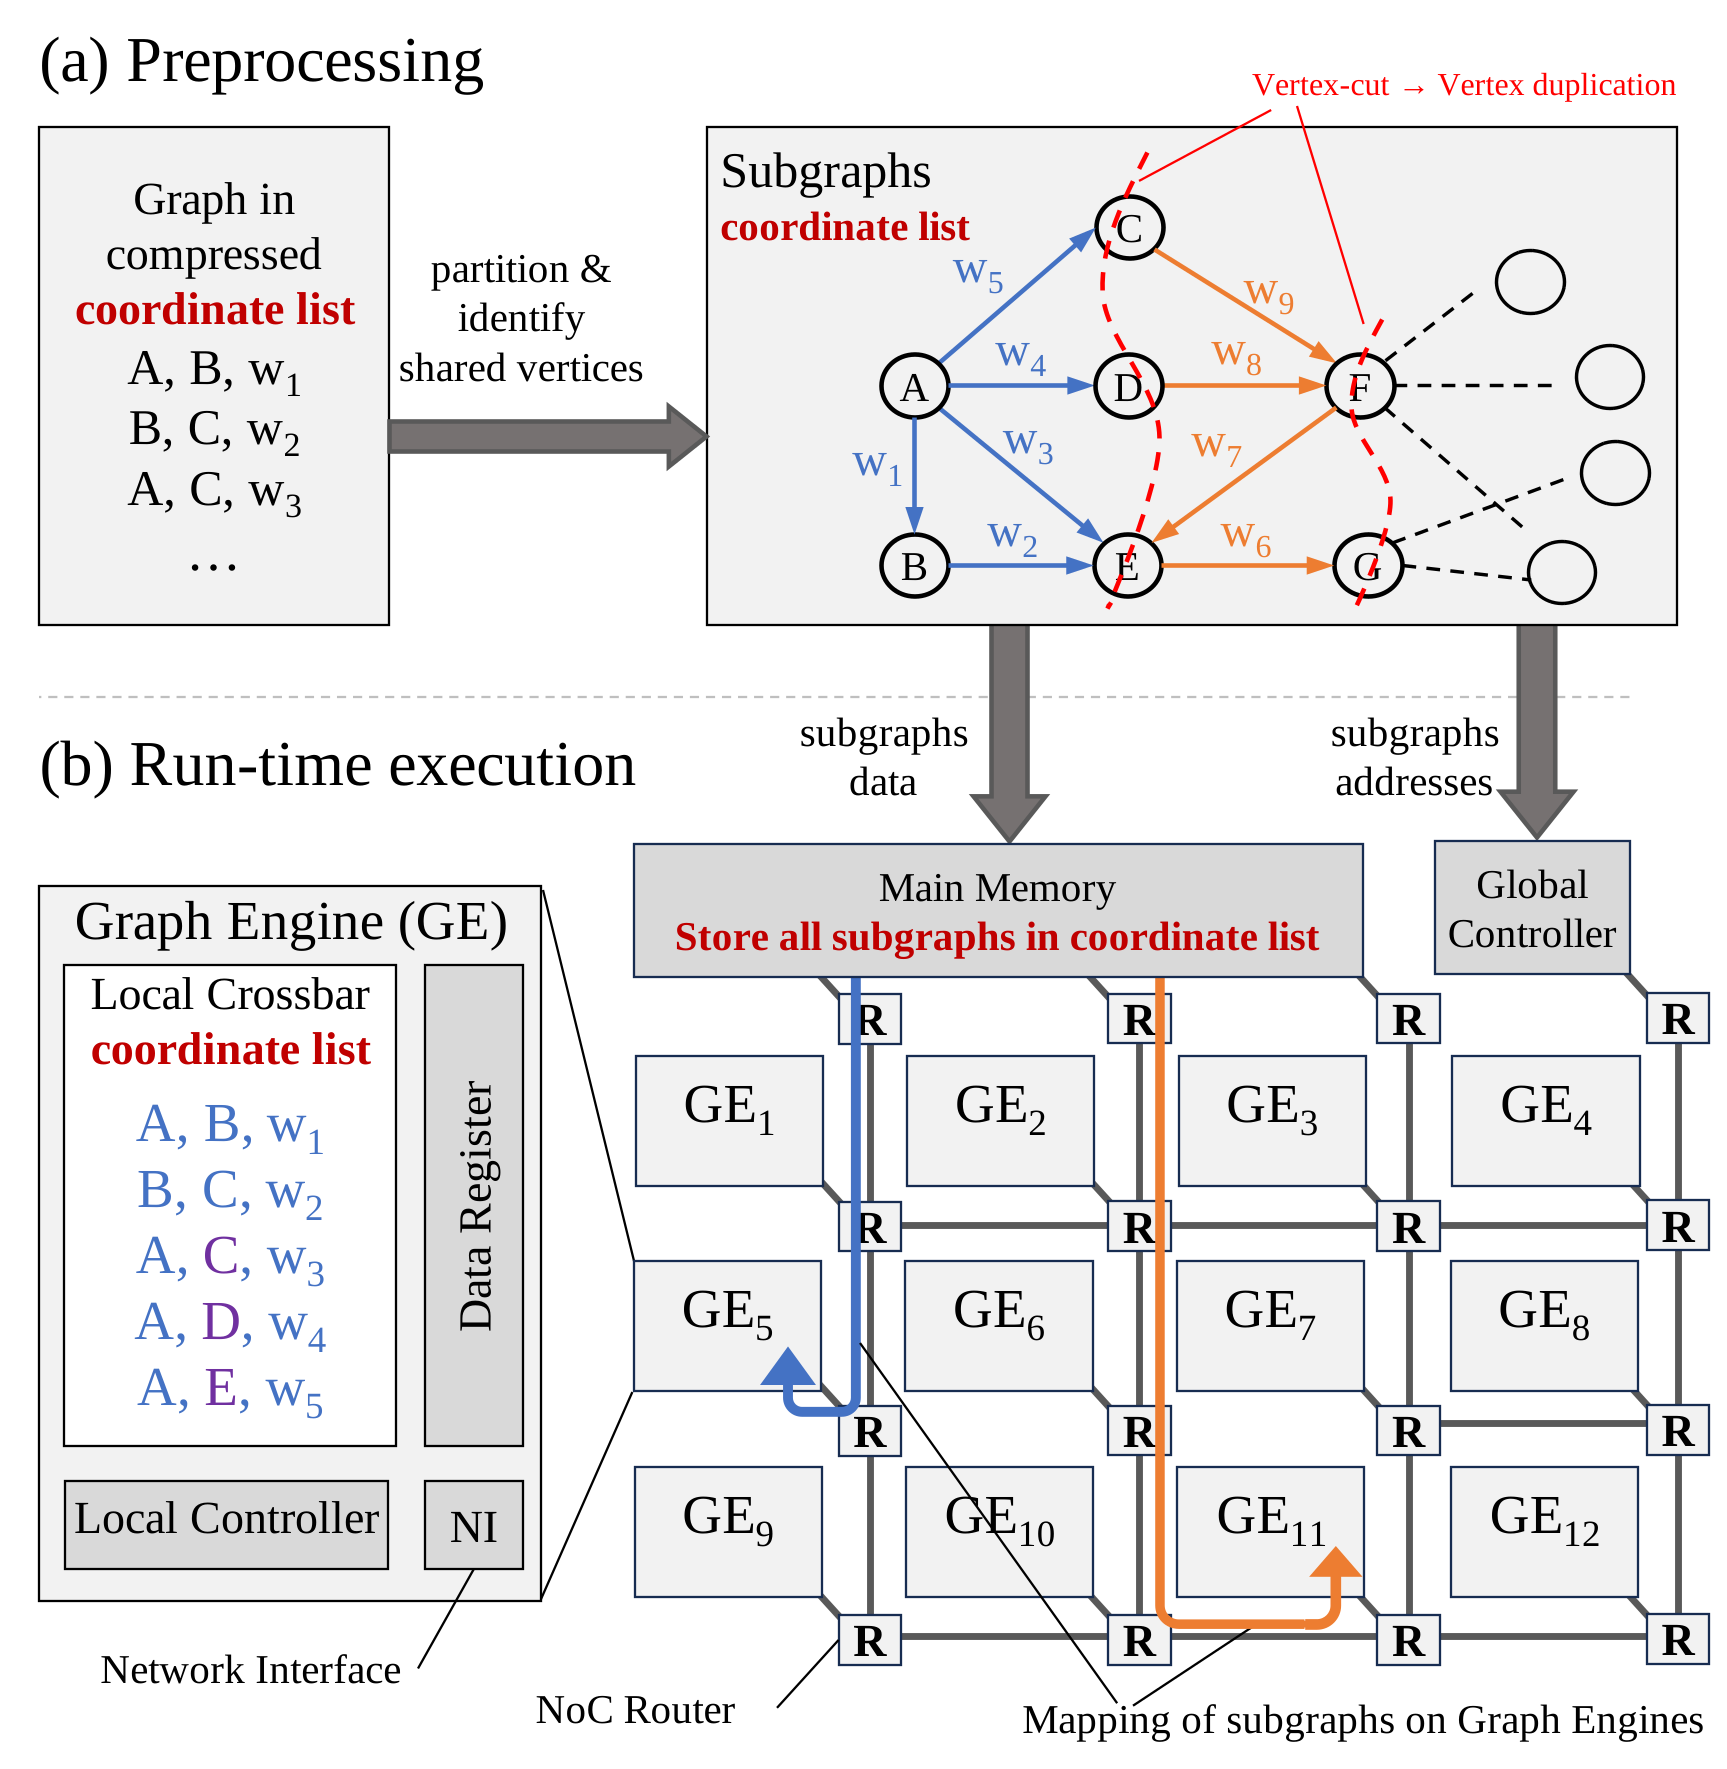
L’accélérateur repose sur la mémoire résistive, une technologie où l’information est stockée sous forme de résistance électrique. Ces cellules sont organisées en matrices denses pouvant être lues en parallèle, avec une logique de traitement simple placée juste à côté. Projeter les données du graphe sur ces matrices permet à l’accélérateur de traiter de nombreuses connexions à la fois, au lieu de les transférer sans cesse entre la mémoire et un processeur distinct. Il en résulte une architecture qui consacre beaucoup moins de temps et d’énergie au déplacement des données, et d’autant plus au travail utile.
Cette approche est particulièrement prometteuse pour les applications reposant sur de très grands graphes. Les institutions financières peuvent par exemple recourir à l’analyse de graphes pour repérer des relations suspectes entre comptes et transactions, tandis que les systèmes de recommandation exploitent les connexions entre utilisateurs, produits et contenus pour proposer des suggestions pertinentes. Des techniques semblables sont également étudiées en découverte de médicaments ou en prévision du trafic, où il est essentiel de comprendre les relations entre un grand nombre d’entités.
Rendre le traitement des graphes plus efficace
Concevoir un accélérateur fondé sur le calcul en mémoire ne règle qu’une partie du problème. Pour rendre cette approche viable sur de grands graphes, il faut aussi considérer comment le graphe parvient aux matrices de mémoire, à quelle fréquence celles-ci doivent être reconfigurées, et comment le matériel peut passer à l’échelle.
Un premier volet de nos travaux porte sur la manière dont les données du graphe sont stockées et préparées. Les graphes réels sont creux : chaque élément n’est relié qu’à une faible fraction des connexions possibles. On les stocke donc couramment dans un format compact qui ne retient que les connexions réellement présentes. De nombreux accélérateurs existants convertissent cette représentation compacte en une table complète avant de la traiter dans les matrices de mémoire. Cette conversion exige un traitement supplémentaire et produit une table largement vide. Notre conception achemine plutôt la représentation compacte directement de la mémoire principale vers l’accélérateur, ce qui permet aux unités de traitement de travailler sur le graphe sous sa forme d’origine et évite cette étape de conversion.
Un second volet tire parti d’une autre propriété des graphes réels : la répétition. Les mêmes petits motifs de connexions peuvent apparaître de nombreuses fois au sein d’un graphe. Nous exploitons cette répétition pour réduire la fréquence d’écriture dans la mémoire résistive. Les motifs fréquents peuvent être configurés une seule fois puis réutilisés à chaque nouvelle occurrence, tandis que les motifs plus rares sont traités dynamiquement. Nous reconnaissons également des motifs structurellement identiques même lorsque leurs éléments portent des étiquettes différentes. Davantage de segments du graphe peuvent ainsi partager une même configuration matérielle, ce qui diminue le nombre d’écritures en mémoire et améliore à la fois l’efficacité énergétique et la durée de vie de la mémoire.
Ensemble, ces techniques permettent à l’accélérateur de consacrer plus de temps au traitement du graphe et moins à sa préparation ou à sa reconfiguration. Sur des jeux de données de graphes réels et des charges de travail standards telles que le calcul de plus courts chemins et PageRank, nos conceptions démontrent des gains substantiels en performance comme en efficacité énergétique par rapport aux accélérateurs de graphes en mémoire antérieurs.
Passer à l’échelle tout en restant fiable
À mesure que nous développons ces accélérateurs, nous regardons au-delà d’une seule unité de traitement, vers les défis que pose la construction de systèmes plus vastes et plus fiables.
Une première direction concerne la communication. Lorsqu’un accélérateur grandit, un nombre croissant d’unités de traitement doivent échanger des données entre elles. À grande échelle, le réseau de communication qui relie ces unités peut devenir déterminant pour la performance globale. Nous explorons les interconnexions optiques comme moyen d’assurer une communication rapide tout en maîtrisant le coût et l’énergie du déplacement des données.
Une seconde direction concerne la fiabilité. Les cellules de mémoire résistive peuvent voir leur valeur dériver progressivement et finir par tomber en panne après des écritures répétées. C’est d’autant plus important pour des accélérateurs qui s’appuient sur les matrices de mémoire pour calculer. Nous étudions des techniques matérielles capables de détecter et de compenser de telles défaillances, afin que l’accélérateur continue de fonctionner correctement à mesure que la mémoire vieillit.
Ces projets couvrent différentes étapes d’un même défi : rendre le traitement des graphes plus efficace, depuis l’entrée des données dans l’accélérateur jusqu’à l’achèvement du calcul. En améliorant la façon dont les graphes sont représentés, stockés, traités et communiqués, et en rendant la mémoire sous-jacente plus résiliente, nous travaillons à des accélérateurs de graphes capables de traiter des charges plus lourdes tout en demeurant rapides, économes en énergie et fiables.
Ces travaux sont menés au LECS par Masoud Rahimi, sous la supervision du professeur Sébastien Le Beux.
Commentaires & corrections
Si vous avez des questions sur cette note ou repérez une erreur, écrivez directement à l'auteur. Nous ajoutons un addendum à l'article lorsqu'une correction s'impose.